
Server-Side Tracking Guide Technik, sGTM und die DSGVO-Falle beim Consent
Kurze Zusammenfassung
Server-Side Tracking ist die Antwort auf strengere Datenschutzregeln und Browser-Einschränkungen wie ITP. Dieser Guide erklärt euch, wie ihr die Kontrolle über eure Daten zurückgewinnen und die Datenqualität signifikant steigern könnt.
Neben dem technischen Aufbau erfahrt ihr:
- Warum das Tracking über den eigenen Server allein noch keinen Datenschutz macht
- Wie ihr die Hoheit über First-Party-Daten behaltet und Adblocker umgeht
- Welche Rolle moderne Conversion APIs (Google Ads, TikTok, ChatGPT) spielen
- Welche Kosten und Ressourcen für Hosting, Subdomains und Traffic-Skalierung einzuplanen sind
- Wie der „Goldstandard“ für rechtssicheres Tracking ohne Cookie-Banner aussieht
Mythos 1:
„Wenn ich die IP anonymisiere, brauche ich keinen Consent“
Viele Unternehmen hoffen auf folgende Gleichung:
Eigener Server + Anonymisierte IP-Adresse = Keine Einwilligung nötig.
Die Antwort lautet: Es kommt darauf an, WAS ihr messen wollt.
Szenario A:
Marketing-Attribution (Customer Journey)
-> ILLEGAL ohne Consent
Wenn euer Ziel ist herauszufinden, ob der/die Nutzer:in, der heute kauft, vor drei Tagen auf eine Anzeige geklickt hat, müsst ihr diesen Nutzer wiedererkennen.
Dafür benötigt ihr eine Unique User ID, die auf dem Gerät gespeichert wird (Cookie/LocalStorage). Das löst die Pflicht zur Einwilligung nach TDDDG (vormals TTDSG) § 25 aus. Auch wenn ihr die IP löscht: Solange ihr das Profil über Tage hinweg verknüpft („Singling Out“), benötigt ihr Consent.
Szenario B:
Reine Reichweitenmessung
-> LEGAL ohne Consent
Wenn es euch nur darum geht zu zählen: „Wie viele Sessions gab es auf Seite XYZ im Zeitraum ABC?“, sieht die Welt anders aus. Hier greift das Prinzip der Stateless Analytics.
- Kein TDDDG-Problem: Es wird nichts auf dem Gerät gespeichert (keine Cookies).
- Kein DSGVO-Problem: Die IP-Adresse wird sofort beim Empfang in einen Hash umgewandelt (mit einem täglich wechselnden „Salt“) und danach gelöscht. Es entsteht kein dauerhaftes Profil.
Ergebnis: Da keine Re-Identifizierung möglich ist, deckt das „Berechtigte Interesse“ (Art. 6 Abs. 1 lit. f DSGVO) diese Messung ab
Deep Dive:
Der technische Datenfluss im Vergleich
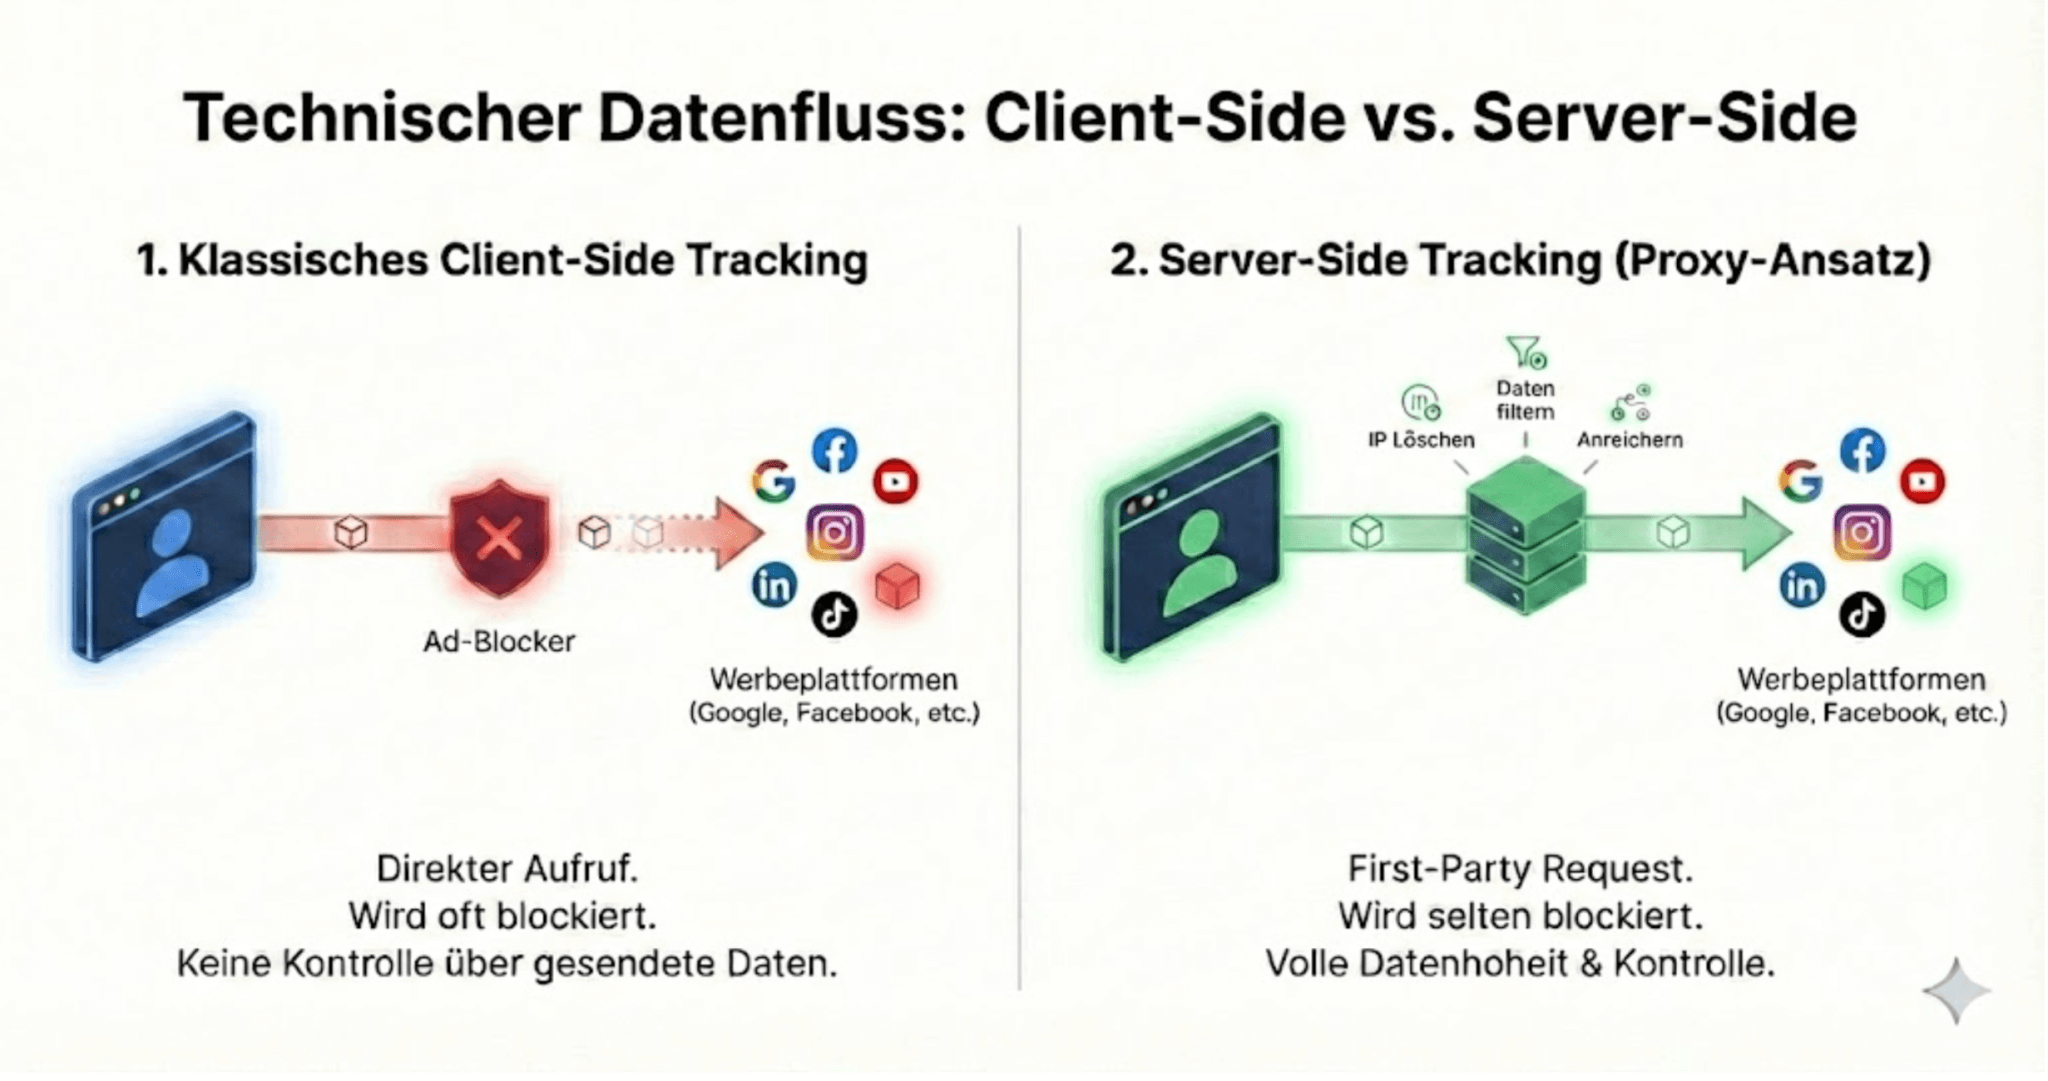
Um zu verstehen, warum Server-Side Tracking so mächtig ist, muss man sich ansehen, wie die Datenpakete (Requests) durch das Internet reisen.
Klassisches Client-Side Tracking (Der alte Standard)
Hier kommuniziert der Browser des Nutzers direkt mit den Servern der Werbeplattformen.
- Der Weg: Browser Google / Meta Server
- Die Technik: Der Browser lädt ein JavaScript (z. B. fbevents.js) herunter. Dieses Skript sammelt Daten und schickt sie direkt an die Plattformen. Absender ist der Browser des Nutzers; im Header des Requests ist somit immer die IP-Adresse des Nutzers enthalten.
- Das Problem: Ad-Blocker und Safari ITP erkennen den Aufruf an Drittanbieter sofort und blockieren ihn. Zudem habt ihr keine Kontrolle darüber, welche Daten das Skript im Browser abgreift.
Server-Side Tracking
(Der Proxy-Ansatz)
Hier schaltet ihr eure eigene Server-Instanz als Kontrollzentrum dazwischen.
- Der Weg: Browser Euer Server (web.eure-domain.de) Google / Meta / TikTok / OpenAI Server
- Die Technik:
- First-Party Request: Der Browser sendet Daten an eure eigene Subdomain. Für Ad-Blocker sieht das aus wie normaler Webseiten-Traffic (First-Party), weshalb er nicht blockiert wird.
- Die Verarbeitung (Container): Euer Server (z. B. sGTM) nimmt das Paket an. Hier habt ihr die volle Kontrolle: Ihr könnt IPs anonymisieren, Daten anreichern (z. B. Margen aus dem CRM) oder sensible Felder filtern.
- Server-to-Server API: Erst jetzt sendet euer Server die bereinigten Daten über direkte Schnittstellen (Conversion APIs) an die Plattformen weiter.
Server-to-Server API: Erst jetzt sendet ihr Server die bereinigten Daten über eine API (z. B. Facebook Conversions API) an die Plattformen weiter.
- First-Party Request: Der Browser sendet Daten an eure eigene Subdomain. Für Ad-Blocker sieht das aus wie normaler Webseiten-Traffic (First-Party), weshalb er nicht blockiert wird.
Die Technik:
Was ist Server-Side Tracking wirklich?
„Ist der Google Tag Manager Server nicht auch von Google?“
Das ist ein häufiges Missverständnis. Der sGTM (Server-Side Google Tag Manager) ist eine kostenlose Software (ein Docker-Image). Ihr mietet die Hardware (z. B. Google Cloud Platform, AWS oder Stape) und installiert dort die Software. Es ist euer Server. Ihr habt die Datenhoheit. Google stellt hier nur den „Container“ bereit, nicht die Server-Infrastruktur.
„Kann ich nicht einfach eine Weiterleitung (Redirect) nutzen?“
Warum der Aufwand mit einem Docker-Container? Reicht nicht ein einfacher Nginx-Proxy oder ein CNAME-Eintrag? Nein, aus zwei Gründen:
- Das Sprach-Problem (Protokoll-Übersetzung): Der Browser sendet Daten meist im Format von Google Analytics 4. TikToks oder Metas API (CAPI) benötigt aber ganz andere JSON-Objekte. Ein einfacher Redirect leitet das Paket nur unverändert weiter. Der Server muss als Dolmetscher (Middleware) fungieren.
- CNAME Cloaking (Apple ist schlau): Wenn ihr nur eine DNS-Weiterleitung einrichtet, erkennen moderne Browser (Safari via ITP), dass dahinter eigentlich ein Tracker steckt. Ein „echter“ Server mit eigener IP-Adresse wird hingegen als vertrauenswürdige First-Party akzeptiert.
- Das Sprach-Problem (Protokoll-Übersetzung): Der Browser sendet Daten meist im Format von Google Analytics 4. TikToks oder Metas API (CAPI) benötigt aber ganz andere JSON-Objekte. Ein einfacher Redirect leitet das Paket nur unverändert weiter. Der Server muss als Dolmetscher (Middleware) fungieren.
Die CAPI-Evolutionsstufe: Meta, Google Ads, TikTok & ChatGPT (OpenAI)
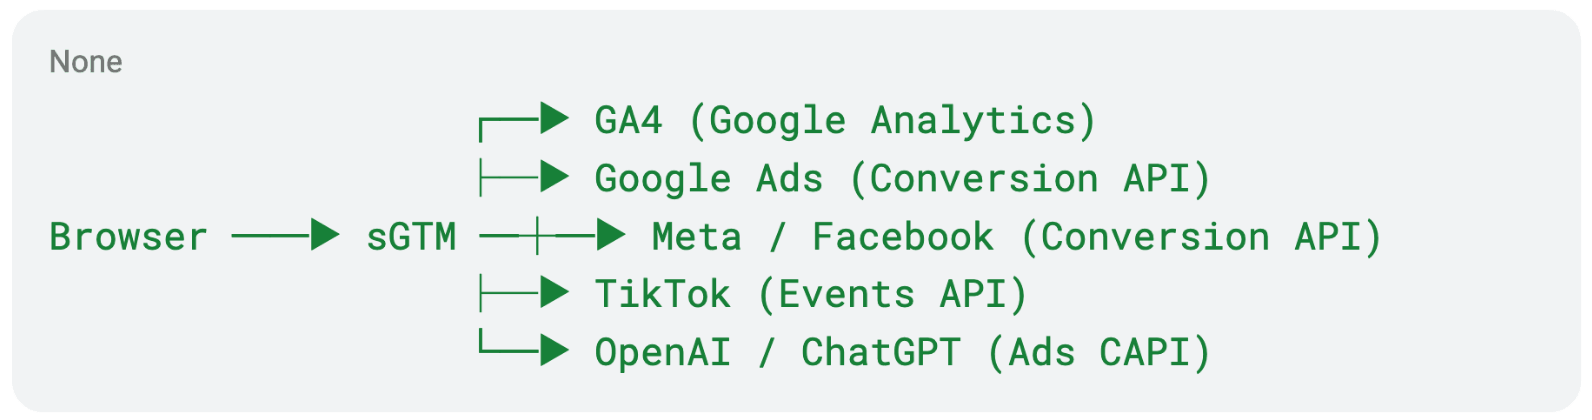
Viele Unternehmen nutzen ihren Server-Container bisher nur für Google Analytics 4 oder die Facebook CAPI. Damit bleibt das größte Potenzial ungenutzt. Mittlerweile bieten alle großen Ad-Plattformen native Server-Schnittstellen:
Die wichtigsten Netzwerke im Überblick:
- Google Ads Conversion API: Standardmäßig läuft Google Ads oft noch über den Web-Container. Wer das Tracking auf den Server verlagert, schickt die Daten direkt via GA4-Event-Stream an Google Ads. Wichtig: Ein Haken bei „Erweiterte Conversions“ im Web-Container ist noch keine echte CAPI – der Übertragungsweg bleibt dort die anfällige Browser-Verbindung.
TikTok Events API: Funktioniert analog zu Meta. Über gehashte Nutzerdaten (SHA-256 von E-Mail oder Telefonnummer) werden Conversions auch ohne Drittanbieter-Cookies korrekt zugeordnet.
ChatGPT / OpenAI Ads CAPI: Für Werbung im OpenAI-Ökosystem (z. B. Chat Cards) nutzt OpenAI eine moderne CAPI-Architektur inklusive Klick-Referenzen (__oppref) und Server-Deduplizierung via event_id.
Build vs. Buy & Kosten: Hosting, Subdomains und Traffic-Skalierung
„Ist der Google Tag Manager Server nicht auch von Google?“
Braucht man den sGTM wirklich oder baut man sich eigene Webhooks?
Technisch kann man Webhooks selbst programmieren. Wirtschaftlich scheitert das meist an Wartung, Deduplizierung und ständig wechselnden API-Versionen der Werbenetzwerke.
Wie setzen sich die echten Hosting-Kosten zusammen?
Wenn ihr eine eigene Subdomain nutzt (z. B. web.eure-domain.de via Cloudflare DNS), leitet diese die Daten an euren Server weiter. Die Kosten hängen vom gewählten Hosting ab:
| Hosting-Modell | Monatliche Richtkosten | Kosten-Skalierung bei mehr Traffic & CAPIs |
|---|---|---|
| Google Cloud (App Engine) | ca. 100 € – 150 € | Basiert auf festen Instanzen. Verträgt meist Millionen Anfragen ohne spürbare Mehrkosten. |
| Google Cloud (Cloud Run) | ca. 30 € – 60 € | Abrechnung primär nach Anzahl der monatlichen Server-Requests (z. B. 2 Mio. Aufrufe). ? |
| Spezialisierte Hoster (z. B. Stape) | ca. 20 € – 50 $ | Abrechnung primär nach Anzahl der monatlichen Server-Requests (z. B. 2 Mio. Aufrufe). |
Gute Nachricht für die Budgetplanung: Das Aktivieren zusätzlicher Conversion APIs (z. B. TikTok oder ChatGPT zusätzlich zu GA4) vervielfacht die Serverkosten nicht. Ein zusätzlicher API-Request benötigt nur minimale Rechenzeit und wenige Kilobyte Datenvolumen.
Der "Goldstandard" ohne Consent: Stateless Analytics
Viele Unternehmen nutzen ihren Server-Container bisher nur für Google Analytics 4 oder die Facebook CAPI. Damit bleibt das größte Potenzial ungenutzt. Mittlerweile bieten alle großen Ad-Plattformen native Server-Schnittstellen:
Das technische Konzept: Hashes mit Salt-Rotation
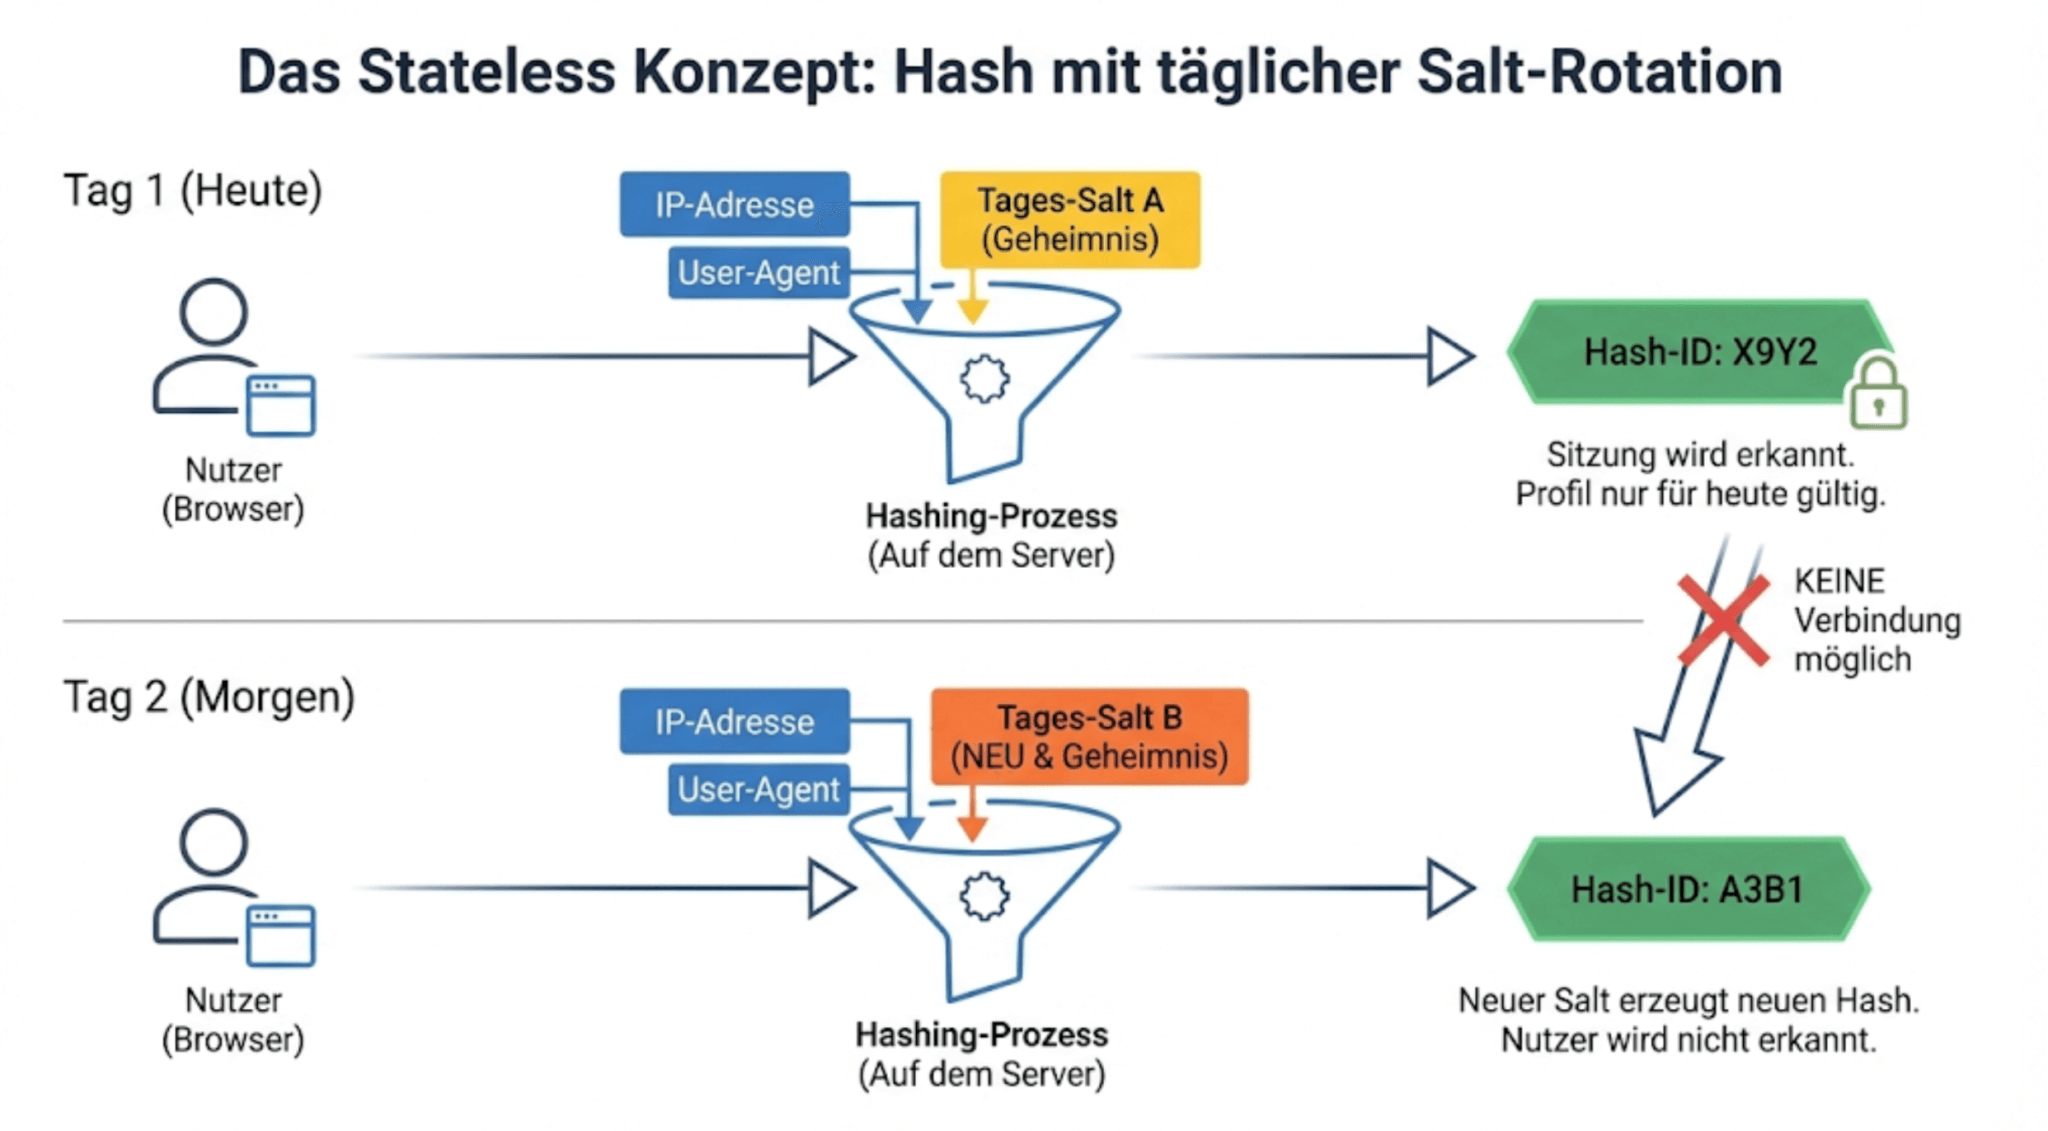
- Das Ziel ist es, eine Sitzung zu erkennen (Nutzer klickt Seite A Seite B), aber das Profil sofort zu vergessen, wenn der Tag vorbei ist.
1. Kein Speicherzugriff: Es werden keine Cookies oder LocalStorage-Einträge gesetzt. Damit entfällt die TDDDG-Einwilligungspflicht.
Der Tages - Fingerabdruck: Auf dem Server wird ein Hash aus den Request-Daten generiert:SessionID=SHA256(IP-Adresse+User-Agent+Tages-Salt)
Der Salt (Das Geheimnis): Der „Salt“ ist eine zufällige Zeichenkette, die nur euer Server kennt. Dieser Salt wird alle 24 Stunden gelöscht und erneuert.
Das Ergebnis
- Heute: Der/die Nutzer:in hat den Hash X9Y2. Ihr seht, dass er 5 Seiten aufruft.
- Morgen: Da der Salt neu ist, ergibt die Formel für denselben Nutzer den Hash A3B1. Das System kennt ihn nicht mehr. Ihr habt Reichweite gemessen, aber keine dauerhaften Profile gebildet.
Häufige Fragen (FAQ)
Kann ich Server-Side Tracking nutzen, um Nutzer ohne Consent wiederzuerkennen?
Nein. Rein technisch ginge das zwar, weil der Server Ad-Blocker umgeht. Rechtlich ist es jedoch ein klarer Verstoß gegen die DSGVO und das TDDDG. Sobald Daten zur Profilbildung oder Wiedererkennung für Marketingzwecke genutzt werden, ist eine ausdrückliche Einwilligung (Consent) zwingend erforderlich.
Hilft Server-Side Tracking gegen Ad-Blocker?
Ja, absolut. Wenn das Tracking über eine eigene Subdomain (web.deinedomain.de) läuft, erkennt der Browser den Datenfluss als normalen First-Party-Traffic der eigenen Website. Ad-Blocker, die primär Aufrufe an bekannte Drittanbieter-Domains (wie facebook.com oder google-analytics.com) blockieren, greifen hier nicht.
Brauche ich Programmierkenntnisse für den sGTM?
In der Regel nein. Der Server-Side Google Tag Manager bietet eine grafische Oberfläche ähnlich dem normalen Web-Container. Für gängige Plattformen (GA4, Meta, Google Ads, TikTok, Stape-Vorlagen) gibt es fertige Tags in der Community-Galerie. Entwickler-Kenntnisse werden erst benötigt, wenn eigene Schnittstellen oder komplexe Daten-Transformationen gebaut werden sollen.
Was ist der Unterschied zwischen serverseitigem Tracking und CAPI?
Server-Side Tracking beschreibt die Infrastruktur (euren eigenen Server bzw. sGTM als Mittelsmann). Die Conversion API (CAPI) ist die konkrete Schnittstelle der jeweiligen Plattform (z. B. Facebook CAPI, TikTok Events API), an die euer Server die Daten schickt. Server-Side Tracking ist also das Fundament, auf dem die Conversion APIs aufbauen.
Muss ich das bestehende Tracking im Web-Container löschen, wenn ich auf CAPI umstelle?
Das kommt auf das Werbenetzwerk an:
- Bei Meta & TikTok (Hybrid-Modell): Hier lässt man Web-Pixel und Server-CAPI oft parallel laufen. Wichtig ist eine gemeinsame event_id, damit die Plattformen doppelt eingehende Events automatisch deduplizieren.
- Bei Google Ads via sGTM: Hier wird das alte Google Ads Conversion-Tag im Web-Container in der Regel pausiert. Der Web-Container schickt die Events nur noch an GA4, und der Server-Container wandelt diese in Google Ads Conversions um.
Praxistipp zur Google Ads Deduplizierung:
Google Ads dedupliziert Käufe zwar automatisch, wenn eine transaction_id (Bestellnummer) mitgesendet wird, bietet aber für Events ohne Transaktions-ID (wie Leads oder Formular-Absendungen) keine generische event_id-Deduplizierung wie Meta oder TikTok. Die sauberste Lösung ist daher, das Google-Ads-Tag im Web-Container zu pausieren und den Datenfluss für Google Ads vollständig über den Server-Container abzuwickeln.
Fazit
Es gibt keine technische Hintertür, die Datenschutzgesetze aushebelt. Aber es gibt intelligente Architekturen.
Wer Attribution will, muss auf ein sauberes Consent-Management, ein perfektes Hybrid-Setup (oder reines sGTM) und Conversion Modeling setzen. Wer reine Reichweite messen will, kann auf Stateless Server-Side Tracking setzen und sich für reine Besucherzahlen vom Cookie-Banner befreien.

Beitrag teilen
Mit dem richtigen Dienstleister zum Erfolg
Zuverlässiges Tracking wird immer anspruchsvoller. Wir zeigen euch, warum serverseitiges Tracking an Bedeutung gewinnt und wie ihr damit Kontrolle, Datenschutz und Datenqualität verbesserst.

Ähnliche Inhalte

Was ist ein CDN?

Barrierefreie Webseite erstellen

Was ist ein Tag Manager?

KI-Hype vs. Realität
Know-How

Der Mehrwert moderner Visitenkarten

Eine Barrierefreiheit Webseite in der Gesetzgebung

Automatisierung im Vergleich
Styleguides im Webdesign
Unsere Leistungen

Digitale Geschäftsprozesse

IT-Sicherheit

Datenstrategie

Online Marketing
