
Server-Side Tracking Guide: Technik, sGTM und die DSGVO-Falle beim Consent
Kurze Zusammenfassung
Server-Side Tracking ist die Antwort auf Adblocker, Safari-ITP und strengere Datenschutzregeln. Richtig aufgesetzt, bekommt ihr deutlich bessere Daten und die volle Kontrolle darüber, was an Google, Meta und Co. geht. Falsch verstanden, wird es zur DSGVO-Falle: Ein eigener Server ersetzt keine Einwilligung.
In diesem Guide erfahrt ihr:
- welche drei Mythen rund um Server-Side Tracking teuer werden können,
- warum eure Daten trotz eigenem Server in die USA gehen können und wo Server-Side Tracking an Grenzen stößt,
- wie der Datenfluss technisch funktioniert und warum eine eigene Subdomain bei Safari allein nicht reicht,
- wie Consent-Status, Conversion APIs und Deduplizierung im Server zusammenspielen,
- mit welchen Kosten ihr für Hosting und Betrieb rechnen solltet,
- wie einwilligungsfreie Reichweitenmessung („Stateless Analytics“) funktioniert – und wo ihre Grenzen liegen.
Server-Side Tracking in einer Minute
Stellt euch eure Website als Firmengebäude vor. Beim klassischen Tracking hat jede Werbeplattform einen eigenen Briefkasten in eurem Foyer. Jeder Besucher wirft automatisch Post hinein – und ihr wisst nicht genau, was in den Umschlägen steckt.
Mit Server-Side Tracking gibt es nur noch eine Poststelle: eure eigene. Sie nimmt alle Informationen entgegen, prüft, ob der Besucher zugestimmt hat, schwärzt, was niemanden etwas angeht, und schickt nur das Nötige weiter – im Format, das der jeweilige Empfänger versteht.
Für euch als Unternehmen bedeutet das drei Dinge:
- Bessere Daten: Weniger Conversions gehen durch Adblocker und Browser-Schutzmechanismen verloren – eure Kampagnen optimieren auf vollständigere Zahlen.
- Mehr Kontrolle: Ihr entscheidet, welche Daten euer Haus verlassen.
- Keine Abkürzung beim Datenschutz: Wer Nutzer:innen wiedererkennen will, braucht weiterhin eine Einwilligung. Die Poststelle ändert nichts daran, ob ihr Post verschicken dürft.
Drei Mythen, die teuer werden
Unsere Einschätzung, keine Rechtsberatung
Mythos 1: „Wenn ich die IP anonymisiere, brauche ich keinen Consent.“
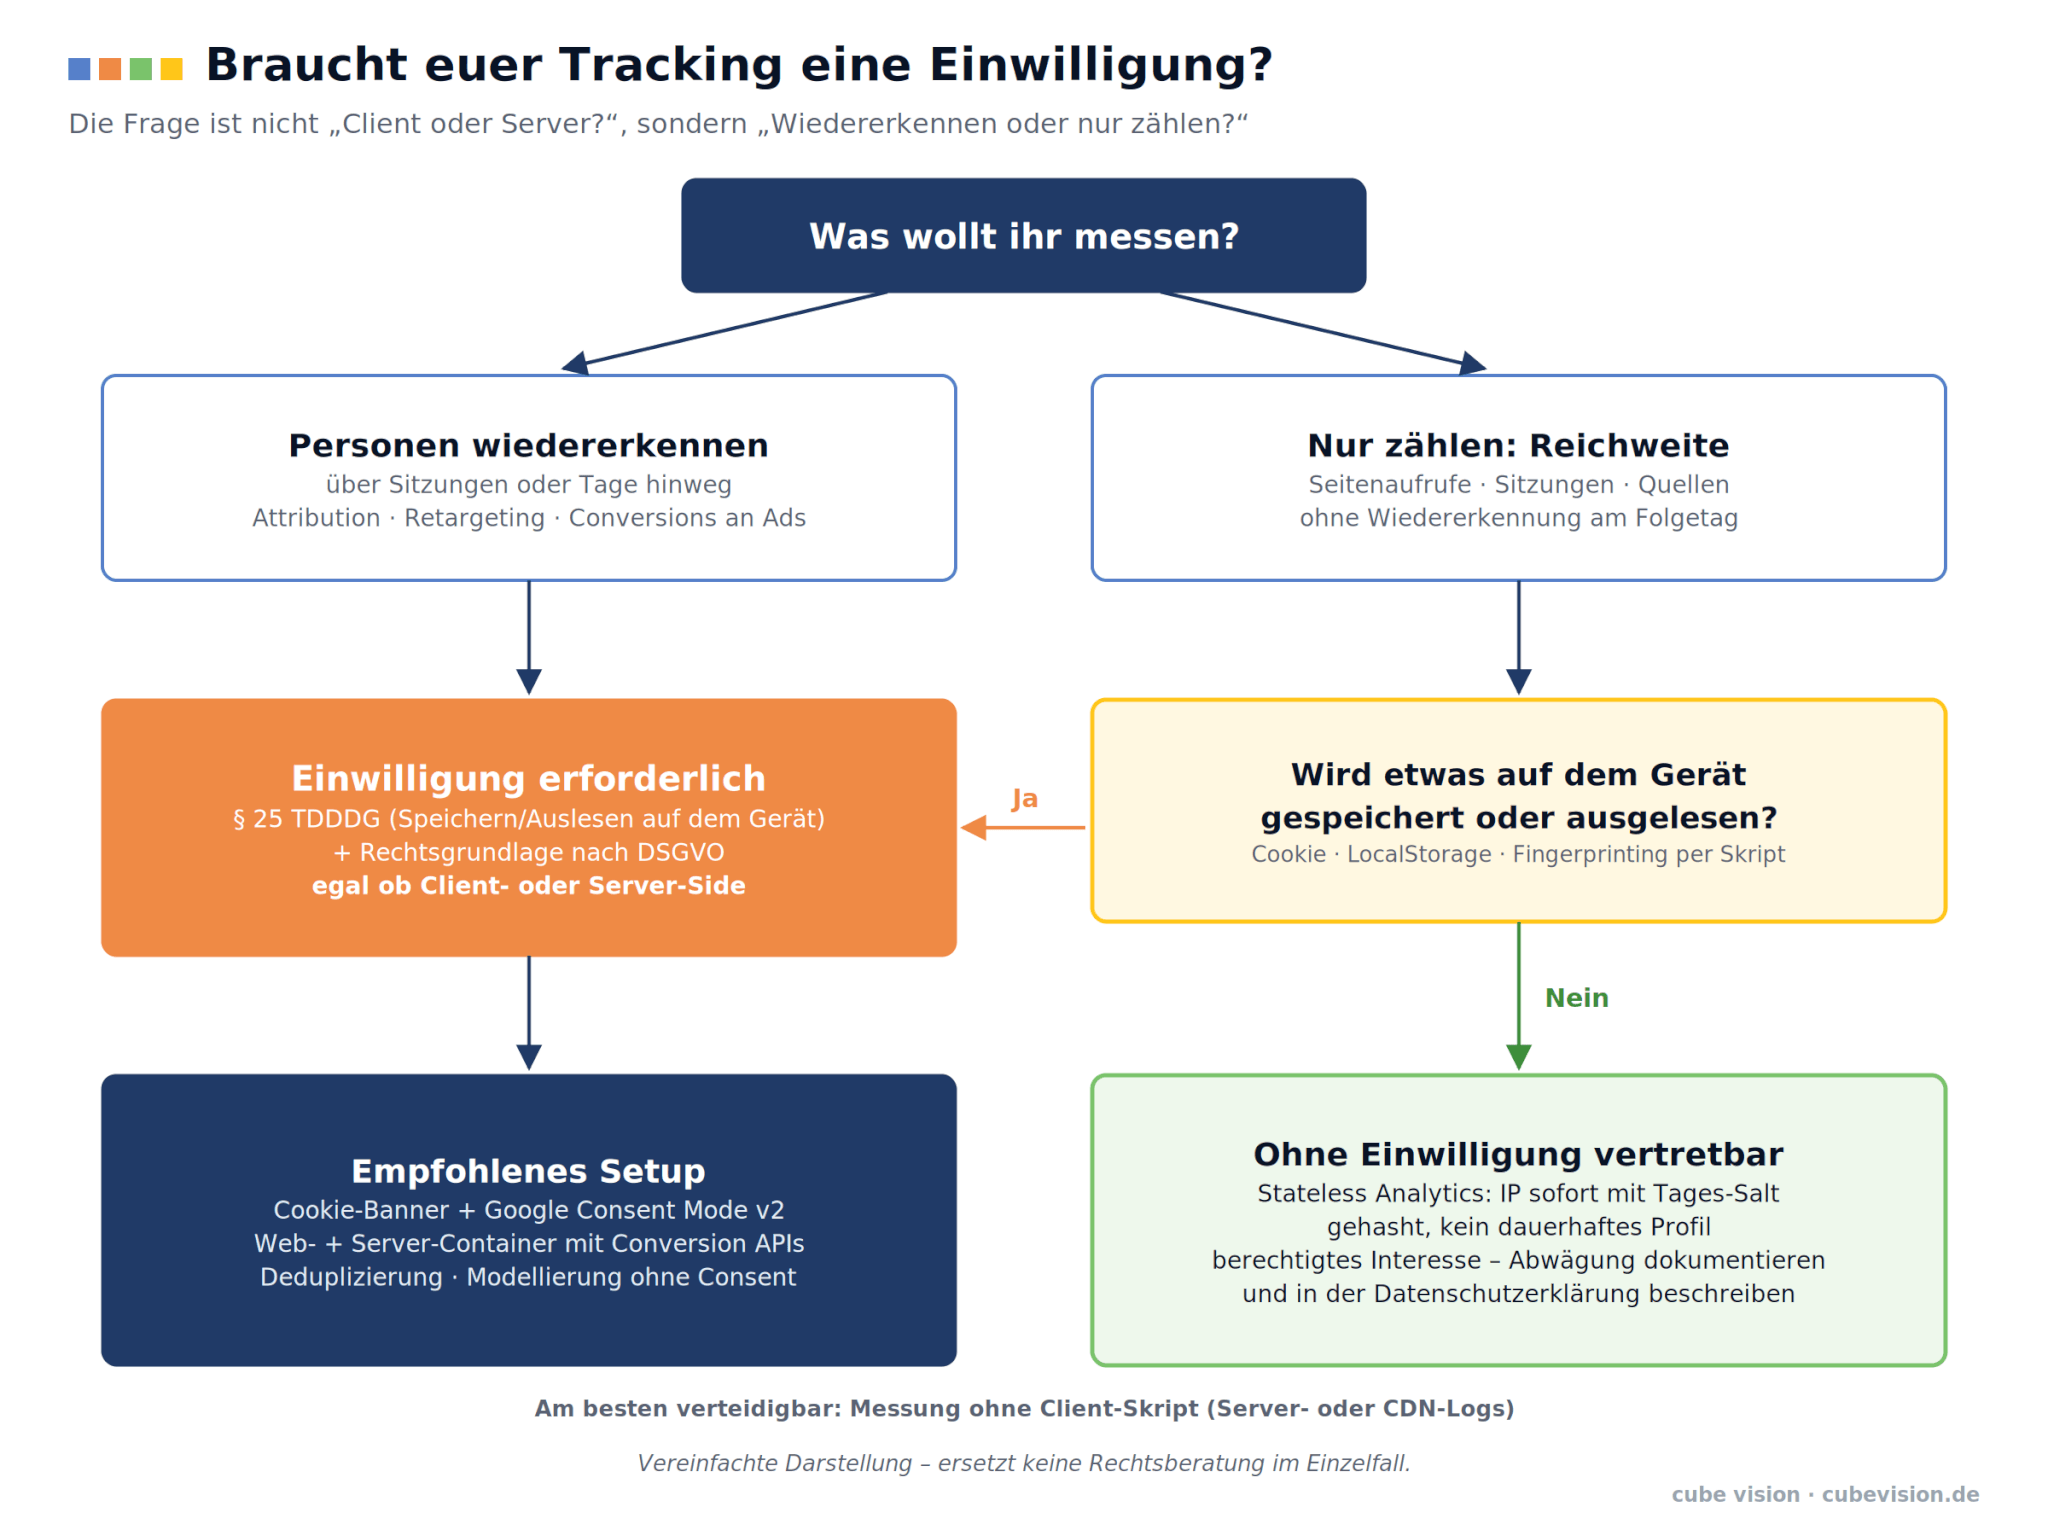
Viele Unternehmen hoffen auf diese Gleichung: eigener Server + anonymisierte IP = keine Einwilligung nötig. Die ehrliche Antwort lautet: Es kommt darauf an, was ihr messen wollt.
Szenario A: Marketing-Attribution
Ihr wollt wissen, ob die Person, die heute kauft, vor drei Tagen auf eine Anzeige geklickt hat. Dafür müsst ihr sie wiedererkennen – mit einer ID, die auf dem Gerät gespeichert wird (Cookie, LocalStorage).
Das löst § 25 TDDDG aus. Auch ohne IP gilt: Sobald ihr ein Profil über Tage hinweg verknüpft, braucht ihr Consent.
Szenario B: Reine Reichweitenmessung
Ihr wollt nur zählen: Wie viele Sitzungen gab es auf Seite XYZ im Zeitraum ABC? Hier kann Stateless Analytics greifen: nichts auf dem Gerät speichern, IP sofort mit wechselndem Salt hashen, kein dauerhaftes Profil.
Rechtsgrundlage ist das berechtigte Interesse (Art. 6 Abs. 1 lit. f DSGVO) – mit dokumentierter Abwägung.
Mythos 2: „Server-Side Tracking ist automatisch DSGVO-konform.“
Der Server ist ein Werkzeug, keine Rechtsgrundlage. Er macht Datenschutz möglich – etwa weil ihr IP-Adressen kürzen oder sensible Felder entfernen könnt, bevor Daten an Dritte gehen. Ob ihr überhaupt messen dürft, entscheidet weiterhin die Einwilligung. Wer über den Server Ereignisse ohne Consent an Meta oder Google schickt, macht denselben Fehler wie vorher – nur schwerer sichtbar.
Und die Daten gehen trotzdem in die USA
Ein eigener Server ändert nichts daran, wohin die Daten am Ende fließen. Was euer Server an Google, Meta, TikTok oder OpenAI weiterleitet, landet bei US-Unternehmen. Rechtsgrundlage dafür ist aktuell meist das EU-US Data Privacy Framework (DPF), dem die Anbieter beigetreten sind. Das Gericht der EU hat das Abkommen im September 2025 bestätigt; über die Berufung entscheidet nun der Europäische Gerichtshof – dieselbe Instanz, die die Vorgänger Safe Harbor und Privacy Shield gekippt hat.
Was der Server-Container daran verbessern kann: Er schickt nur die Felder weiter, die eine Plattform wirklich braucht, und lässt sich in einer EU-Region oder bei einem EU-Anbieter betreiben. Die Übermittlung an die Werbeplattform selbst bleibt.
Mythos 3: „Mit Server-Side sind Adblocker wirkungslos.“
Server-Side Tracking reduziert Datenverluste deutlich, aber nicht auf null. Viele Filterlisten blockieren nicht nur bekannte Domains, sondern auch typische Pfade und Muster wie /gtm.js oder /g/collect. Und wenn das Tag-Skript weiterhin von googletagmanager.com geladen wird, ist der Vorteil der eigenen Subdomain schnell dahin. Professionelle Setups liefern deshalb auch das Skript selbst über die eigene Domain aus.
Unsere Haltung
Ziel ist, technisch bedingte Datenverluste zu vermeiden – nicht, den Willen der Nutzer:innen zu umgehen. Wer im Banner ablehnt, wird nicht wiedererkannt, und es gehen keine personenbezogenen Daten an Werbeplattformen. Zählen dürft ihr trotzdem: anonym, ohne Profil und auch nach Kanal (siehe Stateless Analytics).
Server-Side Tracking und Attribution
Kaum ein Kauf entsteht nach einem einzigen Klick. Meist liegen Social Ads, Suche, Preisvergleich und Bewertungsportale dazwischen – und jede Werbeplattform rechnet sich den Kauf nach eigenen Regeln zu. Welcher Kanal wirklich wie viel beigetragen hat, beantwortet die Attribution.
Server-Side Tracking ändert an den Regeln nichts, verbessert aber die Grundlage: Weniger Kontakte gehen durch Adblocker und Safari verloren, Cookies halten im Same-Origin-Setup länger, und die Conversion APIs liefern den Plattformen stabilere Signale. Voraussetzung bleibt die Einwilligung.
Ausführlich in unserem Attribution-Guide
Wie Klick- und View-Conversions entstehen, welche Standardfenster Meta, Google Ads, GA4, TikTok und ChatGPT Ads nutzen und welche Modelle es gibt – inklusive interaktivem Modellvergleich: Attribution im Online-Marketing: Wem gehört der Kauf?
Deep Dive: Der Datenfluss im Vergleich
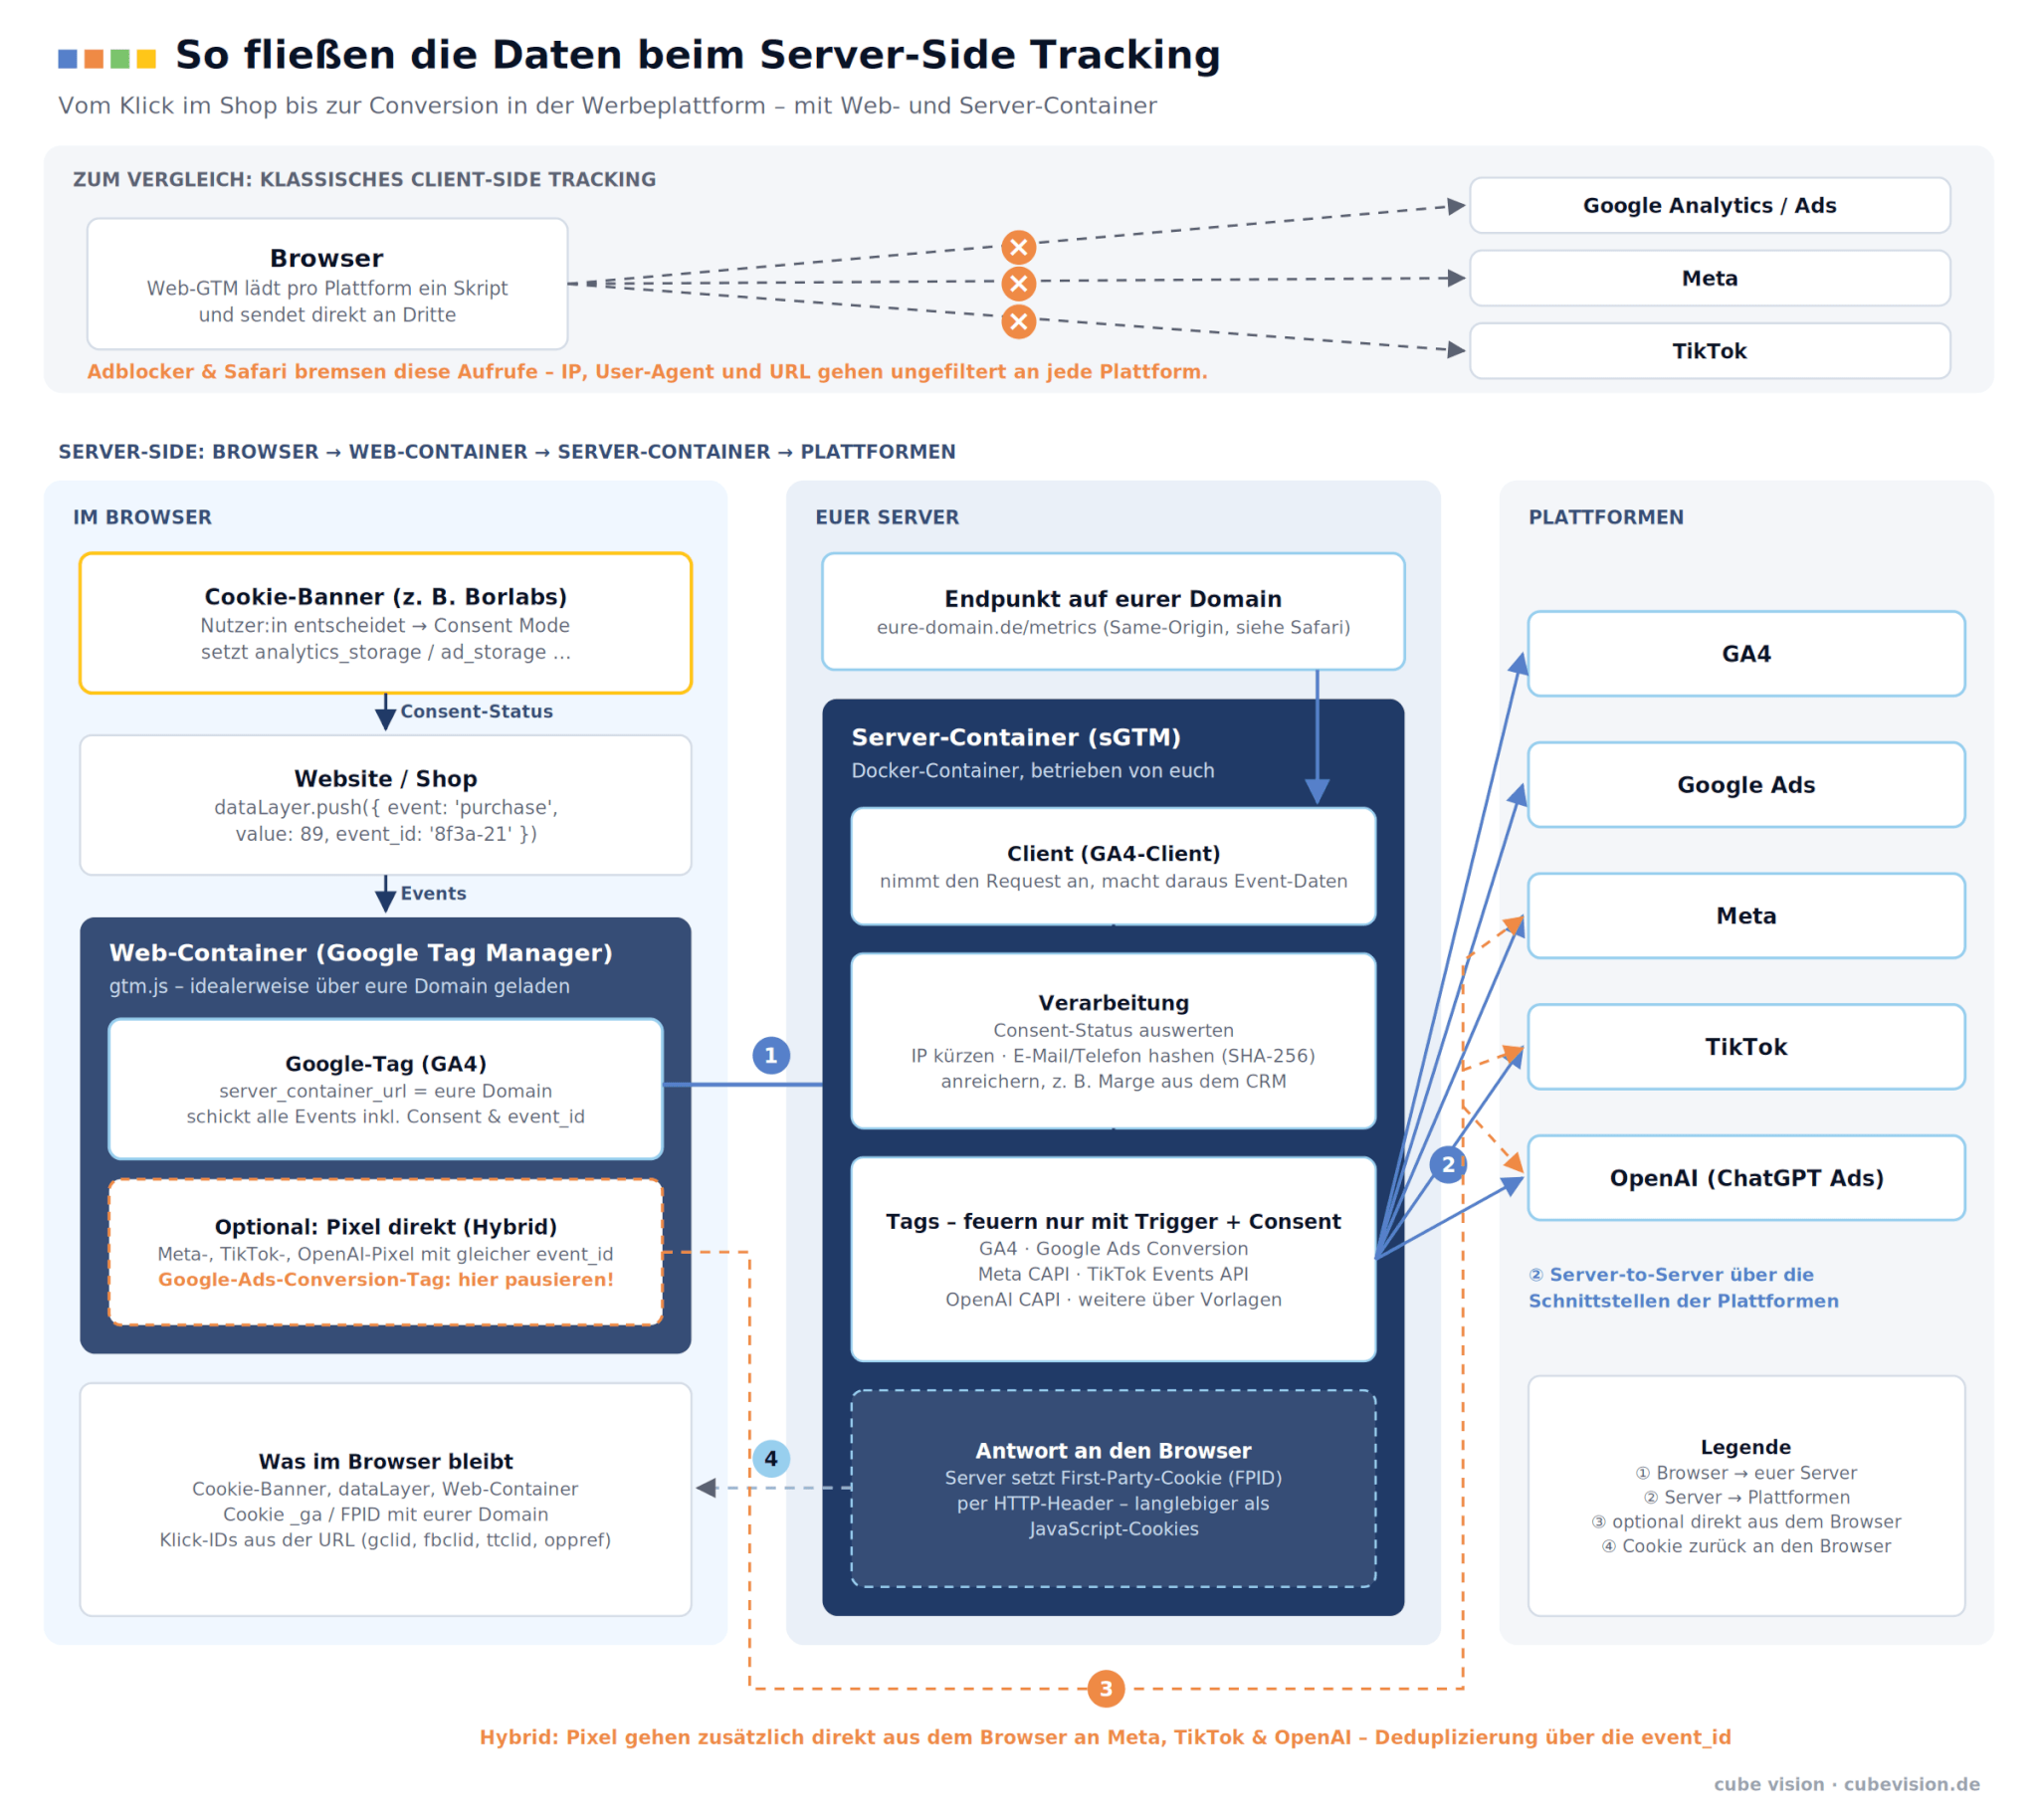
Klassisches Client-Side Tracking
Der Browser kommuniziert direkt mit den Servern der Werbeplattformen: Browser → Google / Meta / TikTok.
Er lädt pro Plattform ein JavaScript (z. B. fbevents.js), das Daten sammelt und direkt verschickt. Absender ist der Browser, im Request steckt also immer die IP-Adresse der Nutzer:innen. Das Problem: Adblocker und Safari erkennen die Aufrufe an Drittanbieter und blockieren oder beschneiden sie. Und welche Daten das Skript zusätzlich ausliest, kontrolliert ihr nicht.
Server-Side Tracking
Ihr schaltet eure eigene Server-Instanz als Kontrollzentrum dazwischen. Wichtig für die Umsetzung: Der Browser spricht nicht direkt mit dem Server-Container. Dazwischen sitzt weiterhin der Web-Container. Der vollständige Weg lautet Browser → Web-Container → Server-Container → Plattformen.
- Consent und Ereignis im Browser: Der Cookie-Banner hält die Entscheidung fest und gibt sie per Consent Mode weiter. Der Shop schreibt jedes Ereignis in den dataLayer, etwa einen Kauf mit Wert und einer eindeutigen
event_id. - Web-Container: Der Google Tag Manager im Browser liest den dataLayer. Statt an Google schickt das Google-Tag (GA4) die Ereignisse über
server_container_urlan den Endpunkt auf eurer Domain – inklusive Consent-Status undevent_id. Für Browser und Adblocker ist das Kommunikation mit eurer eigenen Website. - Server-Container: Ein „Client“ (meist der GA4-Client) nimmt den Request an und macht daraus Event-Daten. Hier prüft ihr den Consent, kürzt IP-Adressen, hasht E-Mail-Adressen und reichert Daten an – etwa mit Margen aus dem CRM. Gleichzeitig setzt der Server per HTTP-Header ein First-Party-Cookie, das länger hält als ein JavaScript-Cookie.
- Server-to-Server: Erst jetzt feuern die Tags im Server-Container und schicken die bereinigten Daten an GA4, Google Ads, Meta, TikTok oder OpenAI – stabil und unabhängig vom Browser.
In vielen Setups laufen im Web-Container zusätzlich noch Tags direkt an die Kanäle, zum Beispiel das Meta- oder das OpenAI-Pixel. Das kann gewollt sein, muss aber mit dem Server abgestimmt werden – sonst wird doppelt gezählt. Mehr dazu unter Doppelt zählen vermeiden.
Was ist der sGTM wirklich?
„Ist der Server-Side Tag Manager nicht auch von Google?“
Ein häufiges Missverständnis. Der sGTM ist eine kostenlose Software, die als Docker-Image bereitgestellt wird. Die Infrastruktur mietet ihr selbst – bei Google Cloud, AWS, einem spezialisierten Anbieter wie Stape oder auf eigener Hardware. Google liefert den Container, betreibt aber nicht euren Server.
Datenhoheit ehrlich betrachtet
„Reicht nicht ein einfacher Proxy oder CNAME-Eintrag?“
Nein – aus zwei Gründen:
- Protokoll-Übersetzung: Der Browser sendet Ereignisse meist im GA4-Format. Meta, TikTok oder OpenAI erwarten ganz andere JSON-Strukturen, Pflichtfelder und Hashing-Regeln. Ein Proxy leitet unverändert weiter; der Server muss übersetzen (Middleware).
- CNAME-Cloaking: Ein CNAME, der auf einen Tracking-Anbieter zeigt, erkennt Safari als verdeckten Drittanbieter und beschneidet die Cookies. Mehr dazu im nächsten Abschnitt.
Ein Reverse Proxy ist trotzdem oft Teil der besten Lösung – nämlich vor dem sGTM, um ihn unter eurer Hauptdomain erreichbar zu machen.
Die Safari-Falle: Warum die Subdomain allein nicht reicht
Lange galt: JavaScript-Cookies werden von Safari nach sieben Tagen gelöscht, Cookies, die euer Server per HTTP-Header setzt, bleiben bestehen. Deshalb setzt der sGTM etwa das GA4-Cookie FPID serverseitig.
Seit Safari 16.4 (2023) prüft Apple zusätzlich, wo der Server steht. Stimmt die erste Hälfte der IP-Adresse des Tracking-Servers nicht mit der eurer Website überein (bei IPv4 die ersten zwei Blöcke), werden auch server-gesetzte Cookies auf maximal sieben Tage begrenzt. Das Gleiche gilt, wenn die Subdomain per CNAME auf einen fremden Host zeigt.
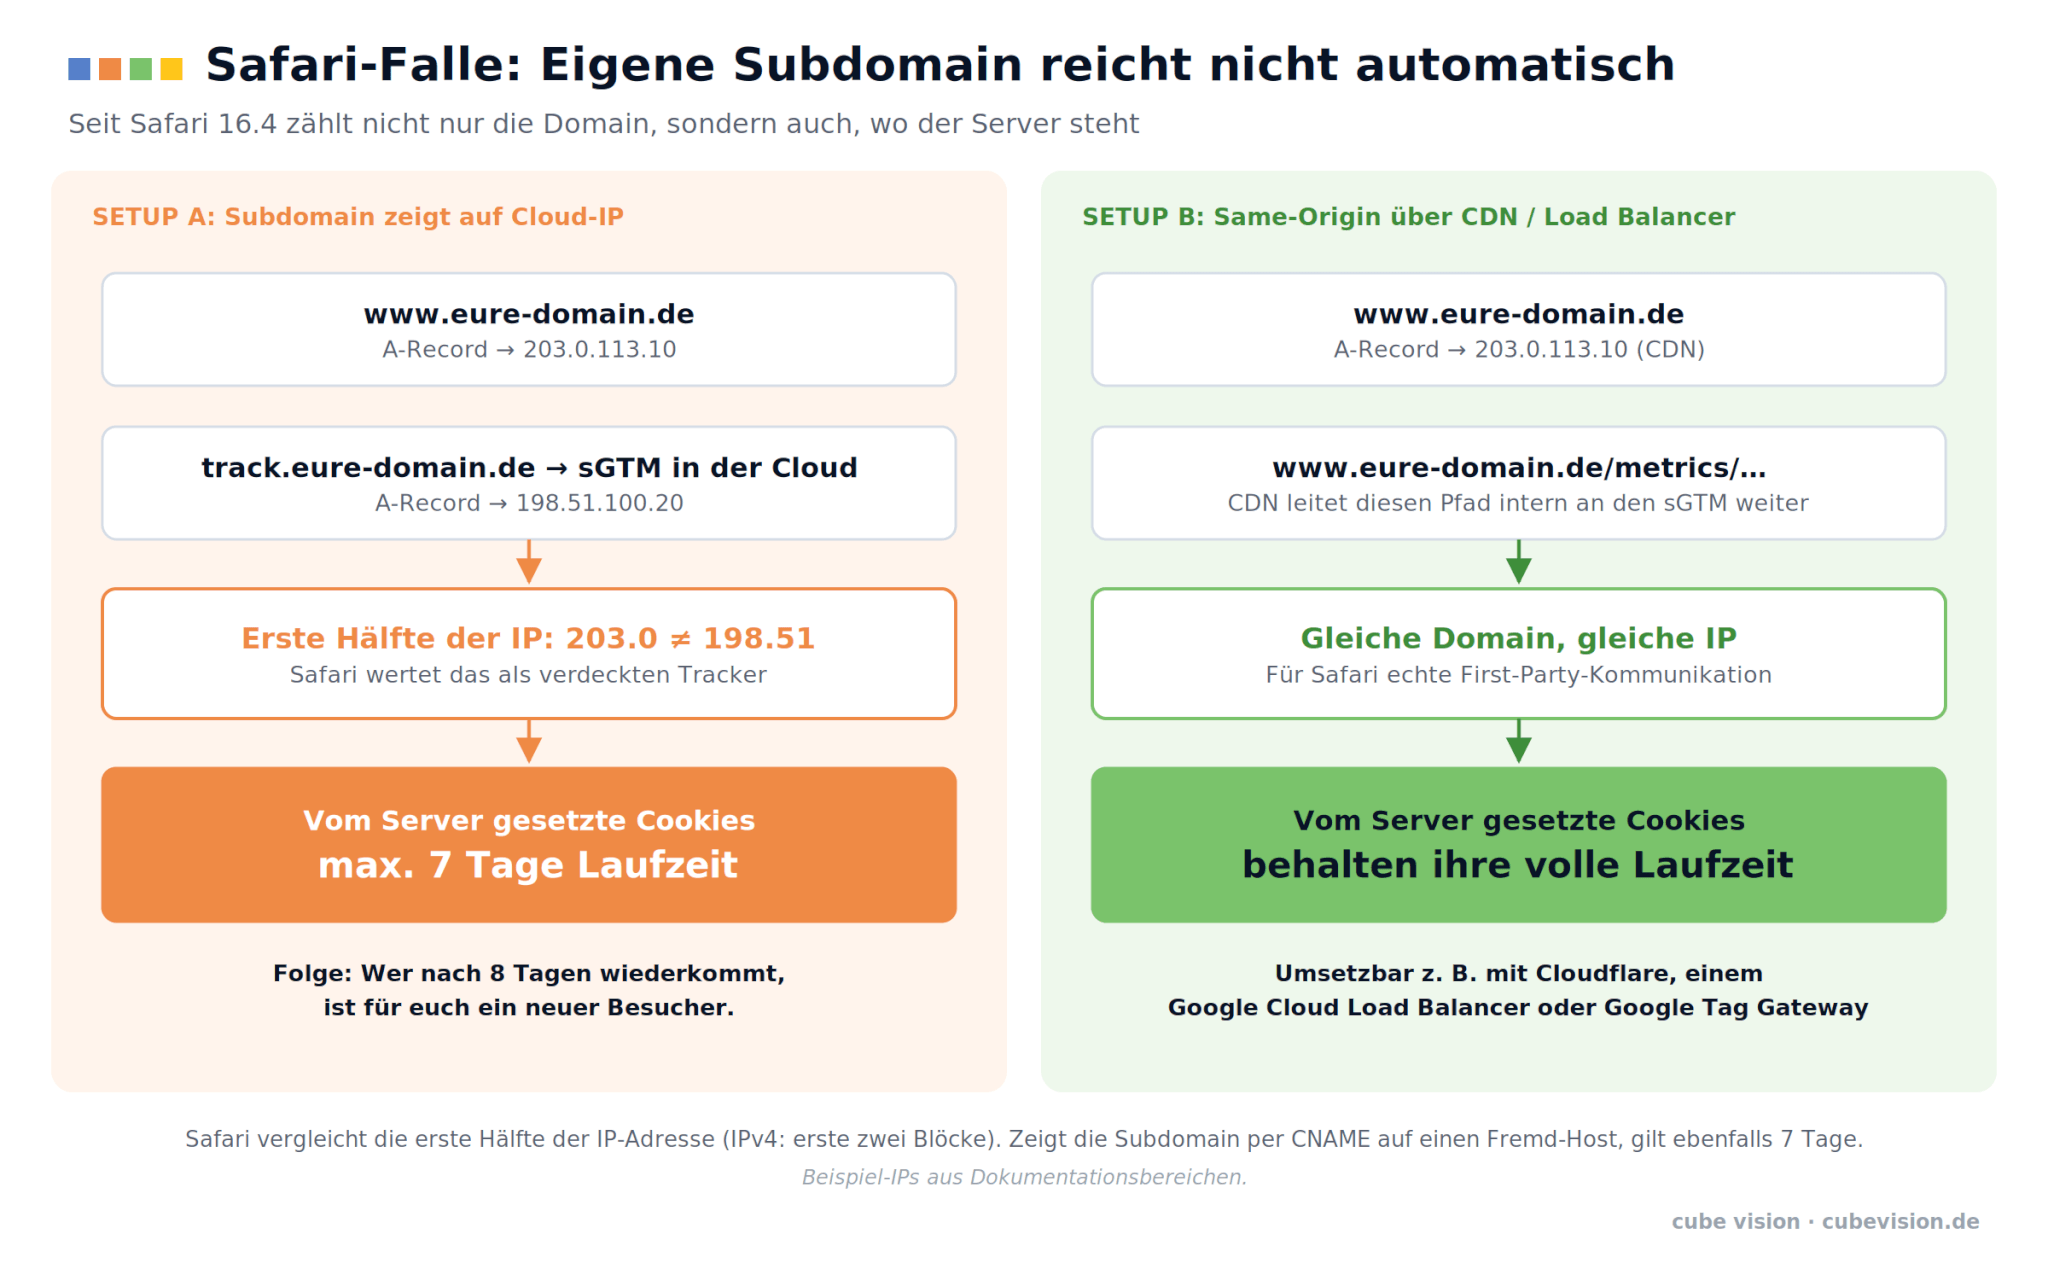
Was das praktisch heißt: Wer wiederkehrende Safari-Nutzer:innen nach mehr als einer Woche noch einer Kampagne zuordnen will (natürlich mit Consent), braucht ein Same-Origin-Setup. Der Tracking-Endpunkt läuft dann als Pfad auf der Hauptdomain, etwa eure-domain.de/metrics/, und ein CDN oder Load Balancer leitet intern an den sGTM weiter. Für Google-Tags gibt es mit dem „Google Tag Gateway for Advertisers“ eine fertige Variante über CDN-Partner wie Cloudflare: Das Google-Tag und seine Messdaten laufen dann über einen Pfad eurer Domain (Stand Oktober 2026). Für Meta, TikTok oder OpenAI ersetzt das keinen Server-Container.
Bei iPhone-lastigen Zielgruppen – und das sind in Deutschland viele – ist das oft der größte einzelne Hebel für die Datenqualität.
Grenze: Wenn die Klick-ID gar nicht erst ankommt
Server-Side Tracking schützt nur Daten, die euer Server bekommt. Safari entfernt Klick-IDs wie gclid und fbclid im privaten Modus, in Links aus Mail und Nachrichten und bei aktiviertem erweitertem Schutz – im normalen Modus kommen sie nach aktuellen Tests weiterhin an, obwohl Safari 26 den Fingerprinting-Schutz für alle Fenster eingeschaltet hat (Stand Oktober 2026). Gegenmittel sind gehashte Kundendaten, bei Google über Erweiterte Conversions.
Consent Mode v2 und der Server
Einfach erklärt: Euer Cookie-Banner fragt, was erlaubt ist. Der Consent Mode überträgt diese Antwort an alle Google-Dienste – auch an euren Server. Der Web-Container hängt den Status an jeden Request an (Parameter gcs und gcd), und die offiziellen Google-Tags im Server-Container respektieren ihn automatisch.
Die eigentliche Fehlerquelle: Für Meta, TikTok oder OpenAI gibt es diesen Automatismus nicht. Dort müsst ihr die Trigger im Server selbst so bauen, dass ohne Marketing-Einwilligung nichts gesendet wird.
Mehr zu Consent Mode v2
Die vier Signale, der Unterschied zwischen Basic und Advanced Mode und warum ad_user_data über Erweiterte Conversions entscheidet, erklären wir im Beitrag Erweiterte Conversions.
Conversion APIs: Meta, Google Ads, TikTok & OpenAI
Viele Unternehmen nutzen ihren Server-Container nur für GA4. Damit bleibt viel Potenzial liegen: Alle großen Werbeplattformen bieten Server-Schnittstellen an, und je besser die Signale, desto besser optimieren ihre Algorithmen eure Gebote.
- Google Ads: Das Google-Ads-Conversion-Tag im Server wandelt GA4-Events in Conversions um. Eine eigene „Conversion API“ wie bei Meta gibt es nicht. Ergänzend gleichen Erweiterte Conversions über gehashte Kundendaten ab – ein Haken dafür im Web-Container ist aber noch kein Server-Tracking.
- Meta Conversions API & TikTok Events API: Der Server sendet Ereignisse mit gehashten Nutzerdaten und Browser-Kennungen (
_fbp,_fbc,ttclid). Je mehr passende Merkmale, desto besser die Zuordnung (bei Meta „Event Match Quality“). - OpenAI (ChatGPT Ads): Seit August 2026 auch in Deutschland. Gemessen wird hybrid mit Measurement Pixel und Conversions API. Wie die Einrichtung im Server-Container funktioniert, zeigt unser Praxisbeitrag ChatGPT Ads Tracking.
Zur Einordnung: Server-Side Tracking ist die Infrastruktur – euer Server als Mittelsmann. Die Conversion API ist die Schnittstelle der jeweiligen Plattform, an die euer Server die Daten schickt.
Wichtig für alle: Gehashte E-Mail-Adressen sind Pseudonyme, keine anonymen Daten. Ihre Übermittlung braucht dieselbe Einwilligung wie ein Pixel.
Doppelt zählen vermeiden
Im Web-Container laufen in der Praxis oft weiterhin Tags direkt an die Kanäle – das Meta-, TikTok- oder OpenAI-Pixel oder ein altes Google-Ads-Conversion-Tag. Kommt der Server-Container hinzu, erreicht dasselbe Ereignis die Plattform auf zwei Wegen. Ob sie es doppelt zählt, hängt vom Netzwerk ab.
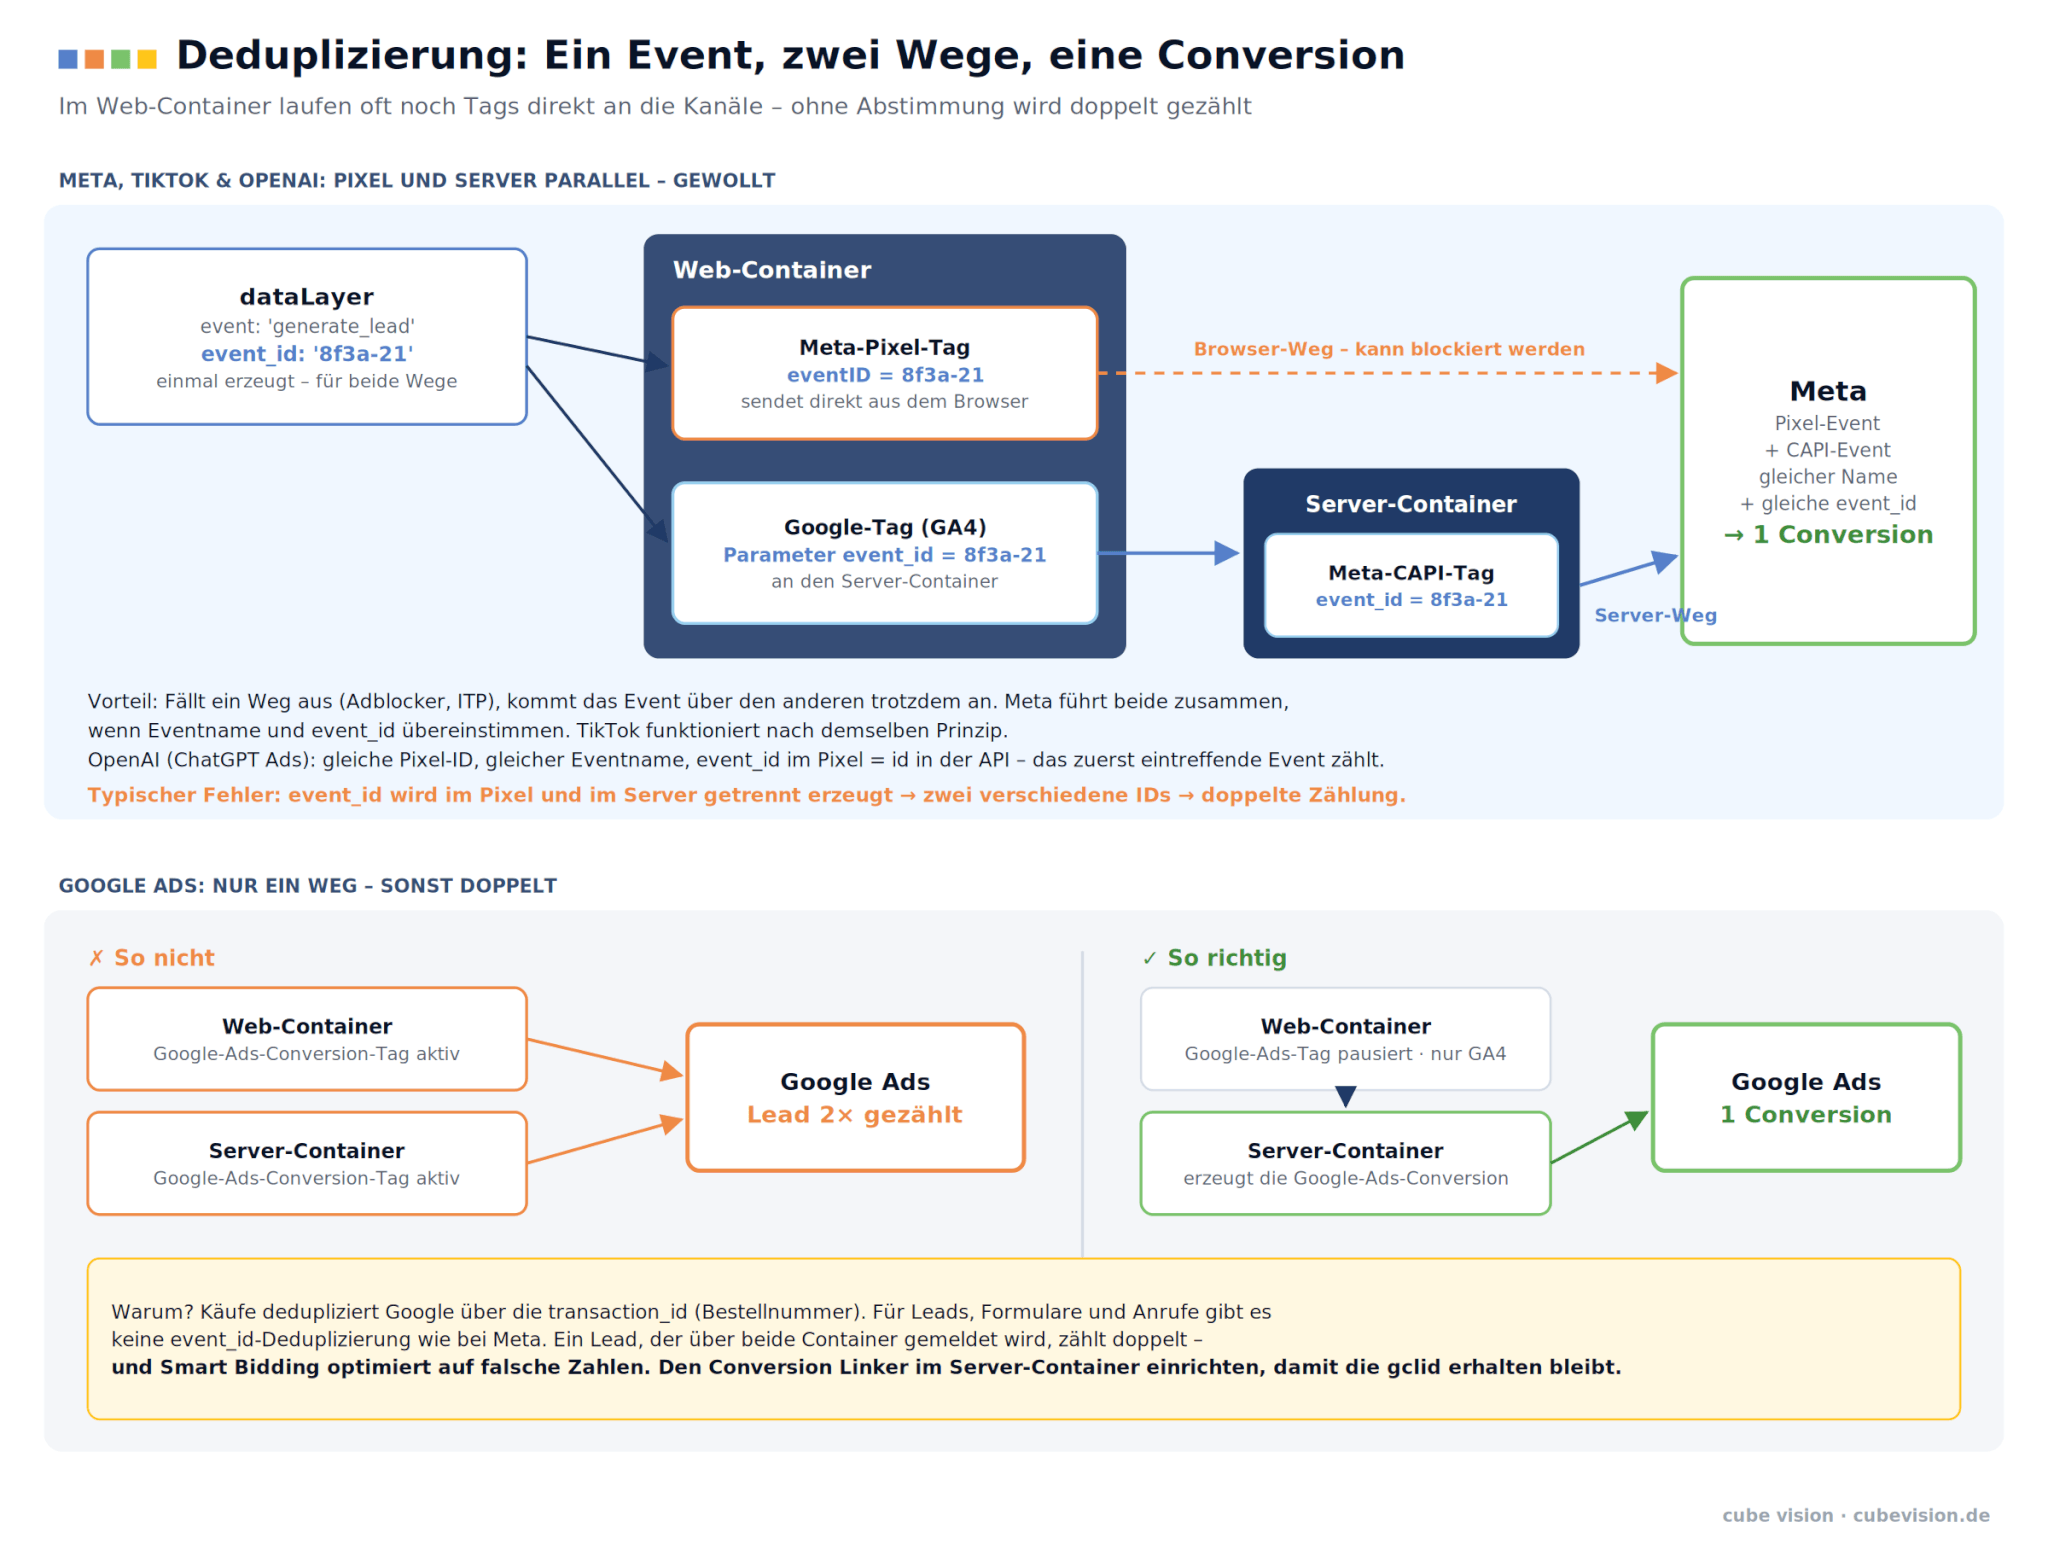
- Meta, TikTok & OpenAI (Hybrid-Modell): Pixel und Server laufen bewusst parallel. Beide Ereignisse tragen denselben Eventnamen und dieselbe
event_id, und die Plattform führt sie zusammen. Entscheidend: Bei OpenAI gehört zusätzlich dieselbe Pixel-ID dazu, und es zählt das zuerst eintreffende Event. Die ID wird einmal im dataLayer erzeugt und an beide Wege übergeben. Erzeugen Pixel und Server sie getrennt, entstehen zwei IDs und doppelte Conversions. Der Vorteil des Hybrid-Modells: Fällt der Browserweg aus, kommt das Ereignis über den Server trotzdem an. - Google Ads: Käufe dedupliziert Google über die
transaction_id. Für Leads und Formular-Absendungen gibt es keine vergleichbareevent_id-Deduplizierung. Die sauberste Lösung: Google-Ads-Tag im Web-Container pausieren, Web-Container sendet nur an GA4, der Server-Container erzeugt die Google-Ads-Conversions. Den Conversion Linker richtet ihr dann im Server-Container ein, damit die Klick-ID (gclid) erhalten bleibt.
Build vs. Buy & Kosten
Braucht man den sGTM – oder baut man eigene Webhooks?
Technisch könnt ihr die Schnittstellen selbst programmieren. Wirtschaftlich scheitert das meist an der Wartung: Deduplizierung, Hashing-Regeln und regelmäßig neue API-Versionen der Werbenetzwerke. Der sGTM mit gepflegten Vorlagen ist für die meisten Unternehmen der bessere Weg. Eigene Entwicklung lohnt sich dort, wo Daten aus CRM oder ERP angereichert werden.
Womit ihr beim Hosting rechnen solltet
Die Preise stammen aus den Angaben der Anbieter (Stand Oktober 2026, ohne Mehrwertsteuer, US-Dollar wie veröffentlicht). Wie viel ihr tatsächlich braucht, hängt von eurer Last ab – deshalb stehen die Annahmen direkt darunter.
| Hosting-Modell | Preis laut Anbieter | Was das für euch heißt |
|---|---|---|
| Google Cloud Run (Googles Standard) | ca. 45 USD pro Server und Monat; Google empfiehlt mindestens 2 Server (an anderer Stelle 3) für Ausfallsicherheit | Grundlast ca. 90–135 USD/Monat. Bei Spitzen startet Cloud Run automatisch weitere Server, die zusätzlich kosten. |
| Stape (spezialisierter Hoster) | Free: 10.000 Requests · Pro: 20 USD (17 USD bei Jahreszahlung) bis 500.000 · Business: 100 USD (83 USD) bis 5 Mio. Requests | Abrechnung nach eingehenden Requests; wenig Betriebsaufwand, EU-Hosting wählbar. |
| Eigener Docker-Betrieb (z. B. EU-Hoster) | Server ab ca. 20 € (unsere Schätzung) | Günstigste Infrastruktur, aber Updates, Monitoring und Ausfallsicherheit liegen bei euch. |
Rechenbeispiel und Annahmen
Wir rechnen grob mit 3 Requests pro Seitenaufruf: der Seitenaufruf selbst plus ein bis zwei weitere Events wie Scrollen, Klicks oder Formulare. Liefert der Server zusätzlich das Tag-Skript aus, kommen weitere Requests hinzu.
- 50.000 Seitenaufrufe im Monat ≈ 150.000 Requests: Stape Pro (20 USD) reicht. Cloud Run bleibt bei der Grundlast von ca. 90 USD.
- 500.000 Seitenaufrufe ≈ 1,5 Mio. Requests: Stape Business (100 USD) oder Cloud Run mit 2–3 Servern (ca. 90–135 USD).
- 3 Mio. Seitenaufrufe ≈ 9 Mio. Requests: nächsthöherer Stape-Tarif bzw. Cloud Run mit zusätzlichen Servern zu Spitzenzeiten.
Aktuelle Preise und Annahmen zur Last – bitte vor der Entscheidung mit euren eigenen Zugriffszahlen und den aktuellen Preisseiten gegenrechnen.
Die versteckten Kostentreiber
- Request-Logging: Standardmäßig schreibt Cloud Run jeden Request in Cloud Logging. Bei viel Traffic kann das mehr kosten als der Server selbst. Google empfiehlt in der Einrichtungsanleitung selbst, diese Request-Logs auszuschließen.
- Scale to zero: Für Test-Container ideal, für Produktion riskant. Kaltstarts führen zu Verzögerungen und verlorenen Requests. Plant mindestens zwei dauerhaft laufende Instanzen.
- Betrieb: Container-Updates, Monitoring und Anpassungen bei API-Änderungen gehören ins Budget – nicht nur die Einrichtung.
Gute Nachricht für die Budgetplanung
Alternativen zum Server-Side Google Tag Manager
Der sGTM ist der verbreitetste Weg, aber nicht der einzige: EU-basierte Server-Side-Plattformen wie JENTIS setzen auf Datenschutz und Betrieb in der EU, kosten dafür aber Lizenzgebühren, Data-Collection-Plattformen wie Snowplow oder Segment verteilen Ereignisse zusätzlich an Data Warehouse und CRM, und Managed-Hosting wie Stape oder Addingwell übernimmt den Betrieb des sGTM. Wir sind an keinen Hersteller gebunden und wählen gemeinsam mit euch aus.
Reichweite ohne Consent: Stateless Analytics
Für reine Reichweitenmessung gibt es einen Weg ohne Einwilligung. Der Server bildet für jeden Besuch eine Tageskennung aus IP-Adresse, User-Agent und einem geheimen Tagesschlüssel (Salt), der um Mitternacht gelöscht wird. Es wird nichts auf dem Gerät gespeichert, und am nächsten Tag ist niemand mehr zuordenbar.
So seht ihr Besucherzahlen, Herkunft und Conversions pro Sitzung von allen Besucher:innen – nicht nur von denen, die zustimmen. Was fehlt, ist die sitzungsübergreifende Attribution. Für die Steuerung von Marketing-Budgets reicht das deshalb nicht.
Ausführlich in unserem Beitrag „Tracking ohne Cookies“
Wo steht ihr? Der Tracking-Reifegrad
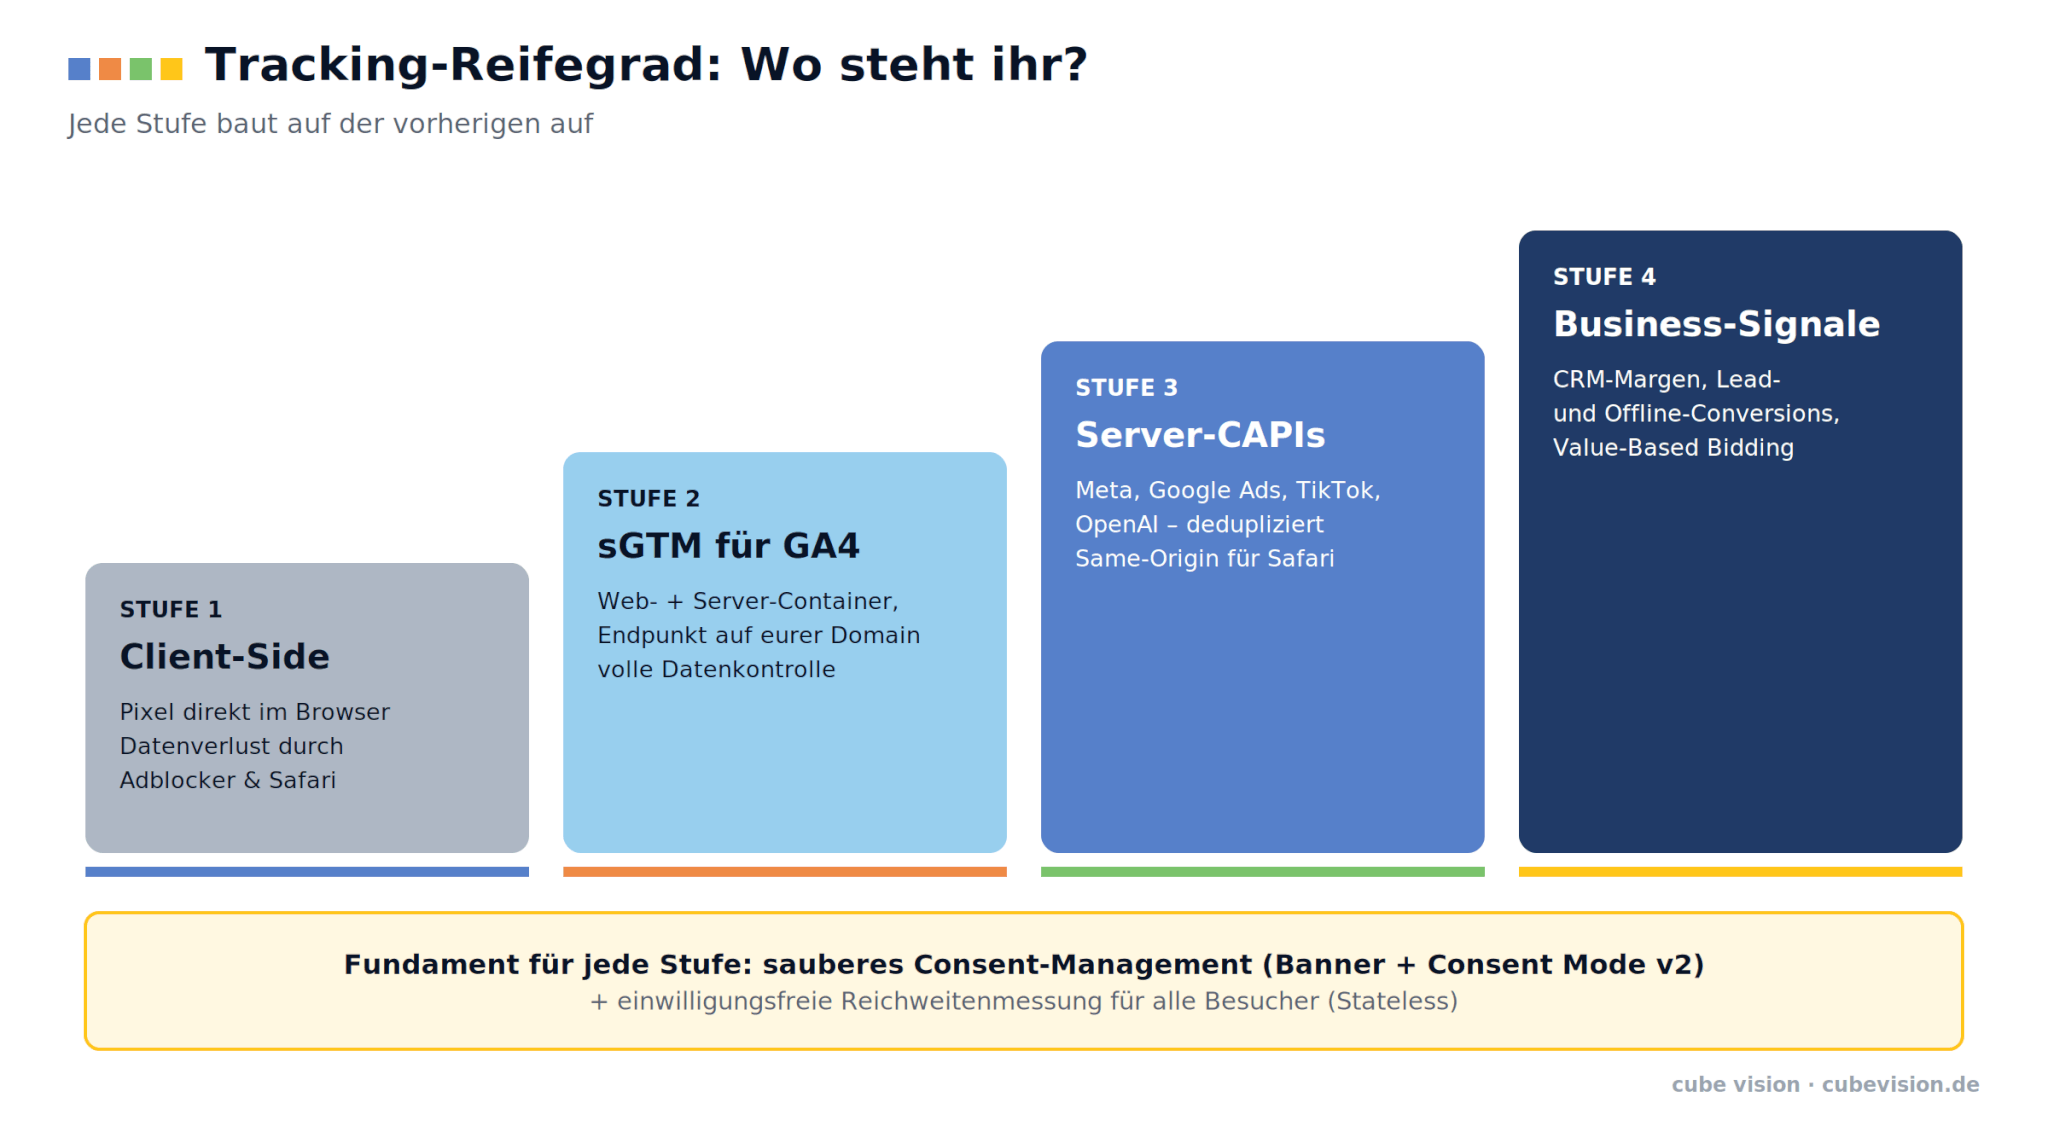
Der 5-Minuten-Selbstcheck
- Läuft euer Tracking-Endpunkt auf derselben IP wie eure Website – oder begrenzt Safari eure Cookies?
- Senden eure Server-Tags für Meta, TikTok und Co. nachweislich nichts ohne Marketing-Consent?
- Werden Google-Ads-Leads nur über einen Weg gemeldet?
- Kennt ihr die Event Match Quality eurer Meta-Ereignisse?
- Fließen Abschlüsse aus dem CRM zurück in eure Werbekonten?
-
Könntet ihr ChatGPT Ads heute messen – mit Pixel, Conversions API und
oppref?
Häufige Fragen (FAQ)
Kann ich Server-Side Tracking nutzen, um Nutzer ohne Consent wiederzuerkennen?
Nein. Technisch wäre es möglich, rechtlich ist es ein Verstoß gegen TDDDG und DSGVO. Sobald Daten zur Wiedererkennung oder Profilbildung für Marketingzwecke genutzt werden, braucht ihr eine Einwilligung – egal, ob Browser oder Server die Daten verschickt.
Hilft Server-Side Tracking gegen Ad-Blocker?
Deutlich, aber nicht vollständig. Über die eigene Domain gehen erheblich weniger Ereignisse verloren. Filterlisten, die typische Pfade oder Skriptnamen erkennen, greifen aber weiterhin – vor allem, wenn das Tag-Skript selbst noch von Google geladen wird.
Brauche ich Programmierkenntnisse für den sGTM?
Für Standard-Setups nicht. Der sGTM hat eine grafische Oberfläche wie der Web-Container, für GA4, Google Ads, Meta, TikTok und viele weitere Plattformen gibt es fertige Vorlagen. Entwicklungs-Know-how braucht ihr für Same-Origin-Routing, eigene Schnittstellen und Datenanreicherung aus CRM oder ERP.
Gehen meine Daten mit eigenem Server nicht mehr in die USA?
Doch, sobald ihr sie an Google, Meta, TikTok oder OpenAI weiterleitet. Der Server bestimmt aber, welche Daten gehen, und kann selbst in der EU laufen. Rechtsgrundlage für die Übermittlung ist aktuell meist das EU-US Data Privacy Framework.
Lohnt sich Server-Side Tracking auch für kleinere Unternehmen?
Sobald ihr regelmäßig Budget in Google Ads oder Meta steckt, meistens ja. Die laufenden Kosten liegen oft unter dem, was schon wenige verlorene Conversions im Monat an Kampagnenleistung kosten. Für reine Reichweitenmessung reicht dagegen häufig eine Lösung ohne Cookies.
Weiterlesen
- Attribution im Online-Marketing: Wem gehört der Kauf? – Klick- und View-Conversions, Standardfenster, Modelle
- Erweiterte Conversions – gehashte Kundendaten und Consent Mode v2 bei Google
- ChatGPT Ads Tracking – Pixel, Conversions API und Einrichtung im Server-Container
- Tracking ohne Cookies – DSGVO-konforme Reichweitenmessung ohne Cookie-Banner
- Was ist ein Tag Manager? und Was ist ein CDN? – die Grundlagen
Quellen
Stand der Angaben: Oktober 2026.
- Europäischer Datenschutzausschuss: Leitlinien 2/2023 zum technischen Anwendungsbereich von Art. 5 Abs. 3 ePrivacy-Richtlinie
- Google: Serverseitiges Tagging mit Cloud Run einrichten (Kosten, Mindestinstanzen, Logging) und Infrastruktur und Kosten planen
- Google: Google Tag Gateway for Advertisers mit Cloudflare
- Stape: Preise und Tarife
- Addingwell: Safari-ITP-Update 2023 (IP-Regel für Server-Cookies)
- PPC Land: Tests zu Klick-IDs unter iOS 26 · TAGGRS: Safari 26 Tracking-Änderungen
- King & Spalding: EuG bestätigt das EU-US Data Privacy Framework · WilmerHale: Berufung vor dem EuGH
Fazit
Es gibt keine technische Hintertür, die Datenschutzgesetze aushebelt. Aber es gibt kluge Architekturen.
Wer Attribution will, braucht ein sauberes Consent-Management mit Consent Mode v2, einen Server-Container mit gut konfigurierten Conversion APIs und Deduplizierung sowie ein Same-Origin-Setup, damit Safari die Daten nicht nach einer Woche verwirft.
Wer nur Reichweite messen will, kann mit Stateless Analytics ohne Cookie-Banner auskommen – mit dokumentierter Abwägung und dem Wissen um die Grenzen. Für die Steuerung von Marketing-Budgets reicht das nicht.
Die meisten Unternehmen brauchen beides. Entscheidend ist, die beiden Welten sauber zu trennen.
Wir sind keine Juristen und können keine Rechtsberatung leisten. Die rechtlichen Aussagen in diesem Beitrag geben unsere Einschätzung wieder – auf Basis unserer Erfahrung und der Zusammenarbeit mit verschiedenen Datenschutzexpert:innen.

Beitrag teilen
Wie viele Conversions verliert euer Tracking?
Im Tracking-Check nehmen wir euer bestehendes Setup auseinander. Ihr bekommt eine schriftliche Übersicht, was heute wohin gesendet wird, wo Daten verloren gehen und wo Risiken liegen – plus einen priorisierten Umsetzungsplan. Danach setzen wir die Lösung auf Wunsch um.
- Consent-Check: Was wird wirklich gesendet?
- Safari- und Adblocker-Verluste
- CAPI-Abdeckung, Deduplizierung und Attribution

Ähnliche Inhalte

Vibe Coding im Unternehmen

Webseite erstellen lassen

SPF, DKIM und DMARC: So kommen eure E-Mails im Posteingang an
ChatGPT Ads Tracking
Know-How

Der Mehrwert moderner Visitenkarten

Eine Barrierefreiheit Webseite in der Gesetzgebung

Automatisierung im Vergleich
Styleguides im Webdesign
Unsere Leistungen

Digitale Geschäftsprozesse

IT-Sicherheit

Datenstrategie

Online Marketing
